硬盘说它很健康,但仪表盘告诉我另一个答案
Diebug硬盘说”我没事”,但你真的相信吗
一台旧Intel NUC迷你电脑,1TB机械硬盘,拿来给家里的老电视当媒体播放机。硬盘用了13年,偶尔发出一些让人不安的噪音。
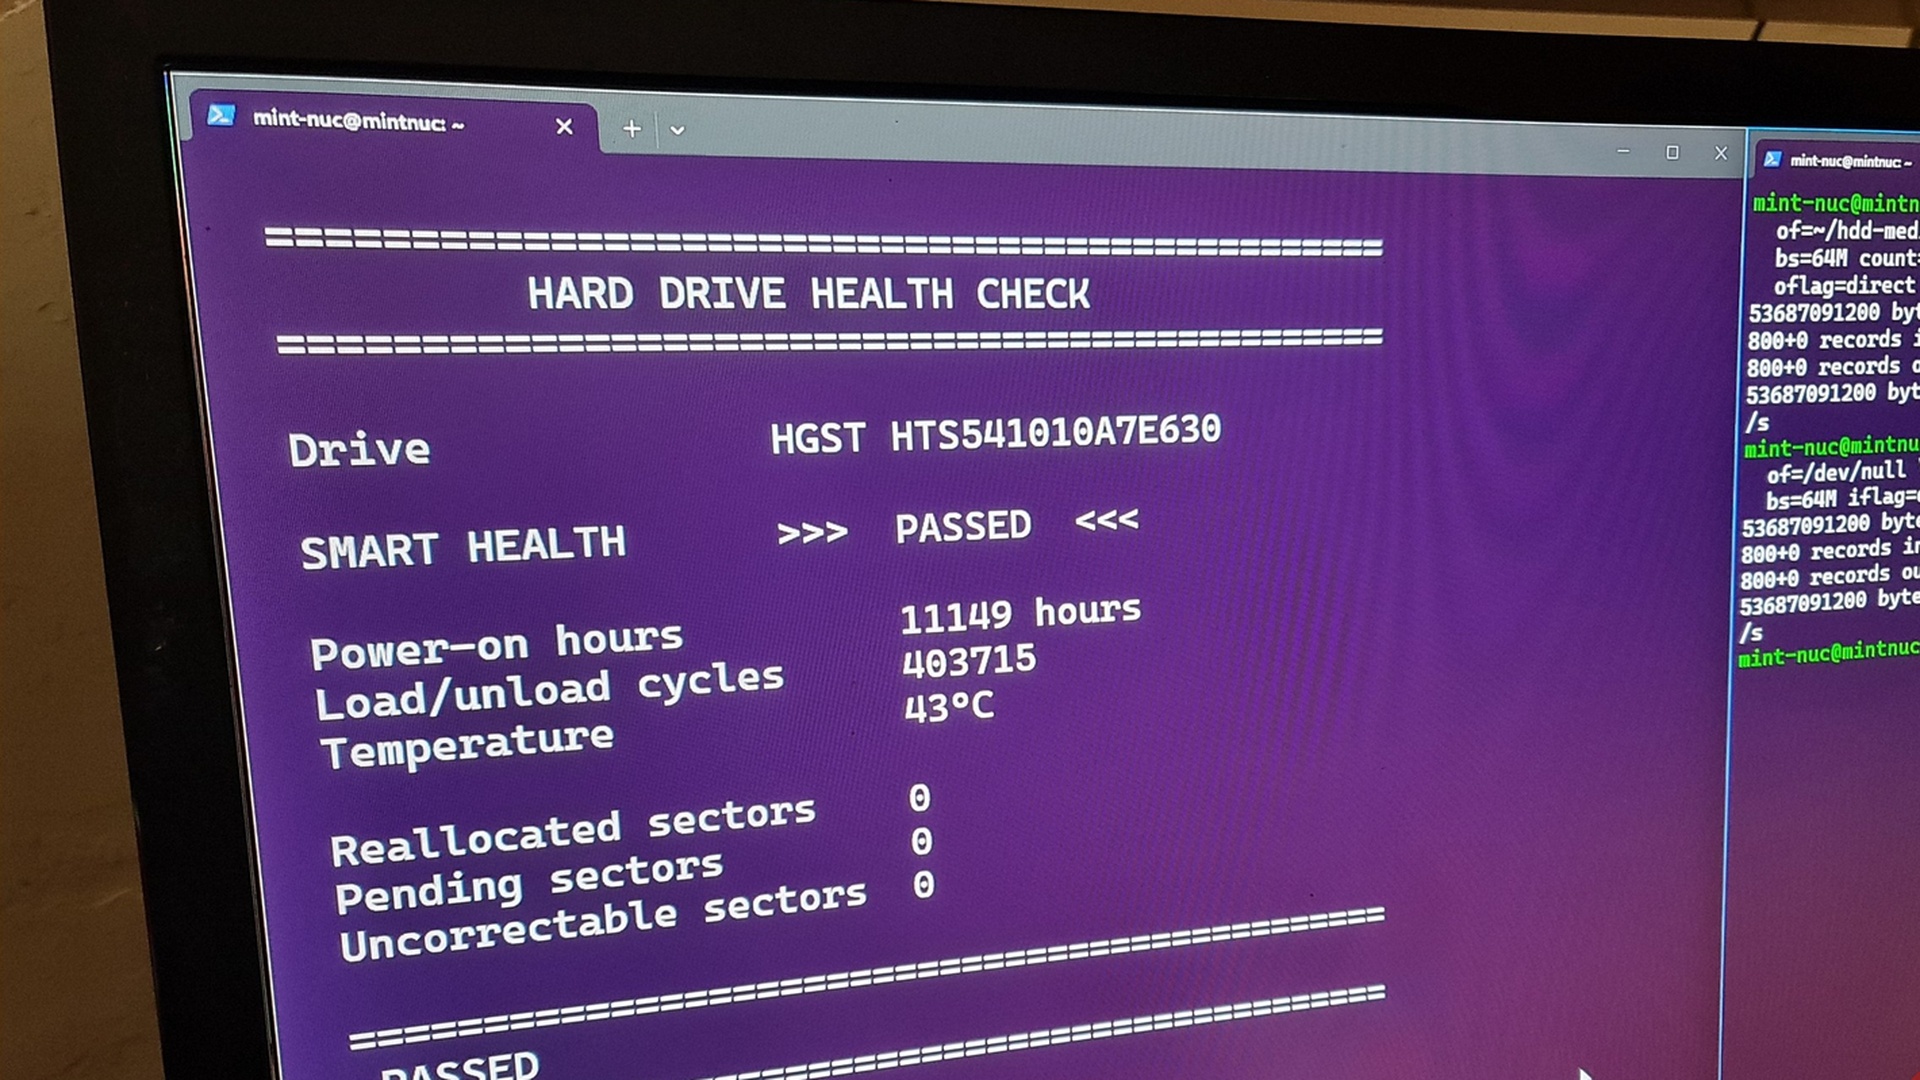
跑了一下基础检测——smartctl -H 显示PASSED,Linux Mint的磁盘工具也说没问题。看起来很健康。
但当我用Scrutiny这个开源工具深入分析后,发现了几个值得关注的数据点。硬盘还在工作,但寿命指标已经进入需要警惕的范围。
单纯看”健康/不健康”的结论不够。真正的风险藏在原始数据里,而大多数用户看不到这些数据。
为什么SMART的”健康”判断不可靠
SMART是硬盘自带的健康监测系统,记录各种物理参数,超过阈值时发出警告。
但它有一个根本缺陷:二元判断——健康或不健康。这个判断基于厂商设定的阈值,而阈值的设定逻辑并不透明。
更复杂的是,SMART报告的数值有两种:归一化值和原始值。归一化值经过缩放,方便比较;原始值是硬盘实际测量的物理量。很多关键的异常信息藏在原始值里,而默认的健康检查只看了归一化值。
某块硬盘的加载/卸载循环次数归一化值为60,看起来一切正常。但原始值显示实际循环次数已经超过40万次——接近这块硬盘设计寿命的三分之二。
只看健康状态,这个警告永远不会出现。
我用Scrutiny看到了什么
Scrutiny是一个开源的SMART数据可视化工具,通过Docker部署,定期采集硬盘数据并绘制趋势图。它让我看到了几个基础工具忽略的细节。
加载/卸载循环次数:归一化值60,原始值403,715。HGST官方规格显示这类硬盘的正常循环次数上限是600,000。40万次不算危险,但已经用掉了三分之二的设计寿命。
通电时间:归一化值75,原始值11,136小时。相当于连续运行一年多。HGST官方建议使用寿命约5年(20,000小时),还在安全范围内,但方向不太乐观。
断电回收计数:原始值66。远未达到20,000的紧急回收阈值,没有问题。
历史最高温度:53°C。HGST的 operating temperature 规格是0~60°C。还在范围内,但接近上限。
重映射扇区和待处理扇区:两个指标都是零。好消息——硬盘还没有出现物理坏道。
SMART数据解读的关键指标
检查自己的硬盘时,重点关注这几个指标:
| 指标 | 正常状态 | 警告信号 |
|---|---|---|
| 重映射扇区计数 | 0 | 任何非零值 |
| 待处理扇区计数 | 0 | 任何非零值 |
| 离线不可校正扇区 | 0 | 任何非零值 |
| UDMA CRC错误 | 稳定或为零 | 持续上升,可能是SATA线缆问题 |
| 通电时间 | 符合预期使用时长 | 远超实际使用时长 |
| 加载/卸载循环 | 低于厂商规格上限 | 超过厂商规格上限 |
| 温度 | 在规格范围内 | 超过规格上限 |
最重要的是看趋势,而不是单次数值。一块用了5年的硬盘有几个重映射扇区是正常的磨损。一块只用了半年的硬盘出现重映射扇区,那就值得高度警惕。
Scrutiny相比基础工具的优势
smartctl 是Linux下最常用的命令行工具,但输出数据密密麻麻,普通人很难解读。
Scrutiny提供历史趋势图,可以看到某个指标是缓慢变化还是突然恶化。突然的跳变通常比缓慢增长更危险——前者可能是物理损坏的开始,后者可能只是正常的磨损。
它还自动解释归一化值和原始值的关系。就像加载/卸载循环的例子,Scrutiny会同时显示两个数值,让你自己判断。
它还提供基于统计学的故障概率估算。虽然不是预测——硬盘什么时候坏没有人能准确预测——但这些数字可以帮助你判断优先级:哪块硬盘需要立即备份,哪块还可以再等一段时间。
你应该怎么做
SMART数据显示异常时,按以下顺序处理。
立即备份重要数据。不要等待,不要侥幸。硬盘可能在下一秒就彻底失效。
如果数据已经备份,考虑更换硬盘。特别是当重映射扇区或待处理扇区开始出现非零值时,更换是最稳妥的选择。
即使SMART显示健康,也要建立定期检测的习惯。Scrutiny可以设置为每天自动采集数据,趋势图比单次检测结果更能反映问题。
永远不要只信任一个检测工具。用smartctl、磁盘工具、Scrutiny等多个工具交叉验证。单一工具的误判虽然罕见,但一旦发生后果严重。
写在最后
硬盘不会弹出对话框说”我快坏了”。它只在SMART数据里留下痕迹,而大多数用户看不到这些痕迹。
这块13岁的HGST硬盘目前还能正常工作,但我不会再把它当作唯一的数据存储。重要文件已经迁移到别处,这块硬盘继续做媒体播放机的任务,但不承载任何不可替代的数据。
定期检查硬盘状态不是杞人忧天。数据丢失的损失永远大于预防的成本。
